9 月 8 日,我把 17 家在马来西亚卖机器人的公司官网逐个测了一遍。服务型、消费型、工业整合三类都有,从槟城的 Cytron 到 Pudu 的本地经销商 Xtrike 都在名单里。
结果是一个整数。
这 17 家里有 14 家放了 robots.txt,也就是那份告诉爬虫「哪里能抓、哪里别抓」的文件。这 14 份文件里,提到过 GPTBot、ClaudeBot、PerplexityBot 这类 AI 爬虫的,有零家。
robots.txt 要算数,得过三关
方法很笨但可靠。用一般浏览器的 User-Agent 去请求每个站的首页和 robots.txt,记录状态码,再看内容。
有一个判断标准要讲清楚,因为它直接影响数字。robots.txt 要算「有」,必须同时满足三件事:HTTP 状态码是 200、内容类型是纯文本、里面真的有指令行。三个条件缺一不可。
这不是吹毛求疵。测的过程中就有一家的 robots.txt 返回 200,但抓下来一看是一整页 HTML 的「301 Moved Permanently」提示页。第一版脚本把它算成了「有」,还误判成提到了 AI 爬虫。加上内容类型和首字符校验才把它剔出去。
另外每一项都从两个网络各测一轮,一次从马来西亚本地,一次从海外节点。这一步后面会讲为什么必要。
十四家有,零家提过
先看主结果。
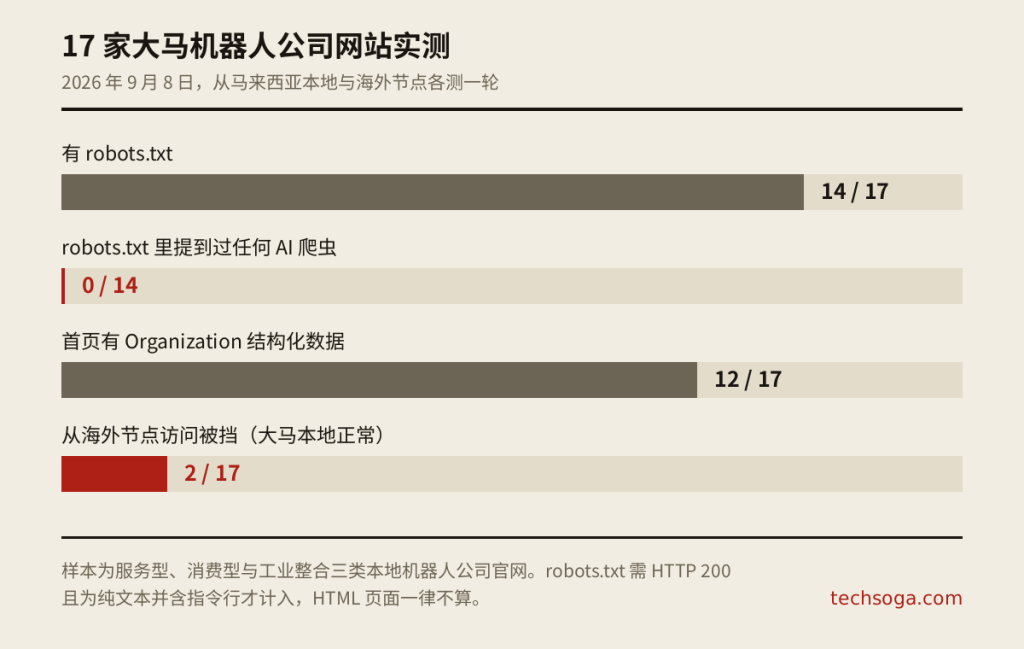
| 项目 | 结果 |
|---|---|
| 首页从大马能打开 | 17 / 17 |
| 有真正的 robots.txt | 14 / 17 |
| robots.txt 里提到任何 AI 爬虫 | 0 / 14 |
| 首页有 Organization 结构化数据 | 12 / 17 |
| 从海外节点访问被挡 | 2 / 17 |
零这个数字比九成更值得注意。本站今年 8 月测过 44 家大马知名企业,当时能读到 robots.txt 的 30 家里有 27 家从没对 AI 爬虫做过任何设置,比例九成。那次的样本横跨银行、电信、航空、零售,各行各业混在一起。
这次只挑一个行业,而且是卖机器人的,结果是十四家整整齐齐,一家都没有。
没设置不等于被屏蔽
这里要澄清一个容易搞反的地方。robots.txt 里没写 GPTBot,不代表 AI 读不到你,反而是默认放行。AI 爬虫现在能不能抓这 14 家网站?能。
所以问题不是「被挡住了」,是「没人管过」。这两者的差别在于,前者是做过判断的结果,后者是从来没有人坐下来想过这件事。而当 AI 开始成为顾客问「大马哪里买送餐机器人」的入口时,没想过就等于把结果交给运气。
三家连 robots.txt 都没有
17 家里有 3 家根本没有这份文件,其中包括那家返回 HTML 提示页的。
没有 robots.txt 本身不是致命伤,爬虫抓不到这份文件时通常按全站可抓处理。但它是一个信号:这个站从来没有人从搜索或者抓取的角度检视过。同一批站里,恰好也是这几家在结构化数据上缺得最多。
五家没写清楚自己是谁
Organization 结构化数据是首页上一段给机器看的自我介绍,写明公司全名、地址和联络方式这些基本身份信息。17 家里有 12 家有,5 家没有。
缺了它,AI 要回答这家公司在哪、卖的是什么,只能从页面文字里猜,联络方式也一样。猜得对不对,你控制不了。对一家要靠询价单做生意的公司来说,被 AI 说错电话号码比不被提到更糟。
两家从海外访问直接被挡
这是这次测下来最实际的一个发现,也是必须用两个网络测才看得出来的。
有 2 家网站从马来西亚本地访问一切正常,状态码 200,内容完整;换成海外节点,同样的浏览器 User-Agent,直接返回 403 拒绝访问。
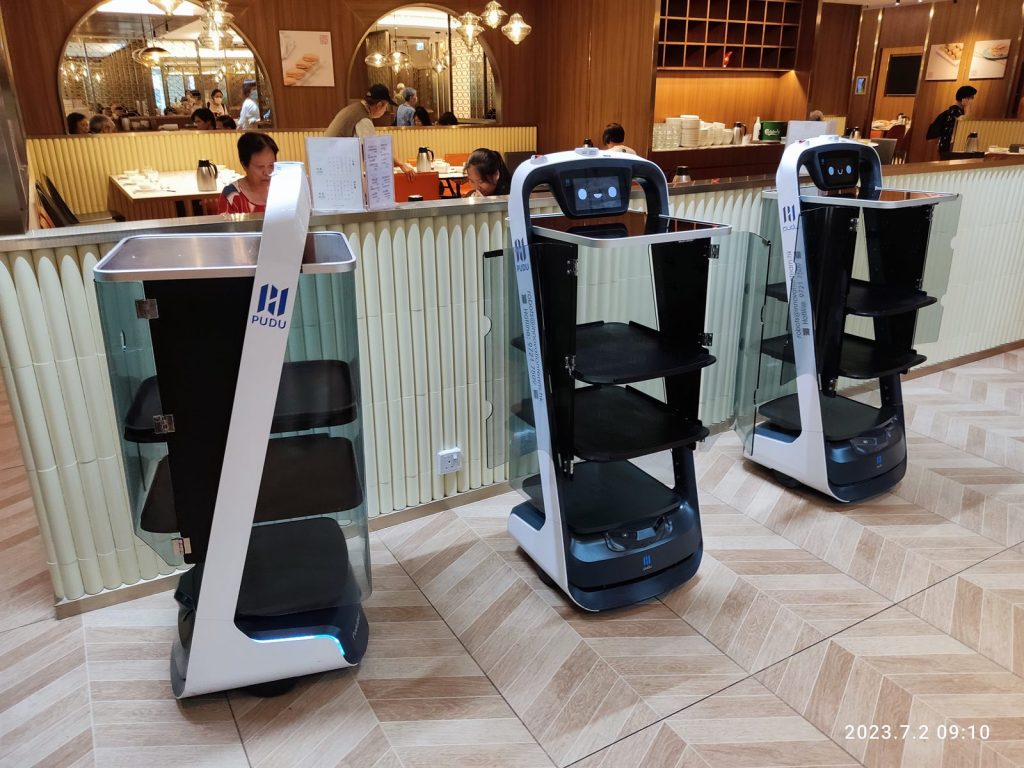
这件事的后果比 robots.txt 严重得多。你在 robots.txt 里写什么,前提是爬虫读得到你的服务器。如果 AI 公司的抓取节点在马来西亚以外,而你的站对海外 IP 一律 403,那么无论你在 robots.txt 里写多少欢迎的话,对方看到的都是一堵墙。
这类拦截多数不是老板决定的,是防火墙或者 CDN 的防爬设定顺手开的,很多人根本不知道自己站上有这一条。
这几件事今天就能改
- 先从海外测一次自己的站。 找个境外的朋友,或者用任何一个海外节点打开你的网站首页。如果打不开,先解决这个,其他都是白搭。
- 确认 robots.txt 是纯文本。 浏览器打开 yourdomain.com/robots.txt,看到的应该是几行纯文字。如果看到网页版面或者错误页,那份文件等于不存在。
- 决定要不要让 AI 抓。 想被引用就明确放行,不想就明确屏蔽。关键是做一次决定,而不是让它一直空着。
- 首页补上身份信息。 公司全名、注册号、地址、电话,用结构化数据写一次。这是成本最低、见效最直接的一步。
- 把型号和价钱写成文字。 放在图片里的规格表,AI 读不到,搜索引擎也读不到。
这几条加起来,一个懂行的人半天能做完。
为什么这个行业更该在意
机器人这门生意有个特点:客户买之前一定会问一圈。餐厅老板要买送餐机器人,工厂要找整合商,这些都不是看广告下单的东西,是先搜一轮,问过价,再坐下来谈的。
过去这个「先搜」发生在 Google 上,现在越来越多发生在 AI 对话框里。而 AI 的答案来自它抓得到的内容。这 17 家公司卖的是最前沿的自动化设备,自己的网站却停在没人管过 AI 怎么读的状态,这个反差挺说明问题的。
实测时间为 2026 年 9 月 8 日,样本 17 家,从马来西亚本地与海外节点各测一轮。判定标准写在上文,任何人都可以用同样的方法自己复测一遍。